Ik gebruik al heel lang cloudgebaseerde chatbots. Omdat grote taalmodellen enorme rekenkracht vereisen, waren deze programma's de enige beschikbare optie. Maar met LM Studio en LLM Quantum Models kan ik nu goede modellen offline uitvoeren met hardware die ik al bezit. Wat begon als nieuwsgierigheid naar lokale AI, is uitgegroeid tot een krachtig alternatief dat niets kost, offline werkt en me volledige controle geeft over mijn interacties met de AI.

Deze verschuiving werd noodzakelijk nadat ik zelf had ervaren wat er gebeurt als je per ongeluk gevoelige informatie deelt met cloud AI. Uiteindelijk deelde ik mijn pincode met ChatGPT tijdens wat aanvoelde als een normaal gesprek. Dat moment van onachtzaamheid deed me beseffen dat ik cloud AI als een digitaal notitieboek had behandeld, zonder rekening te houden met de beveiligingsimplicaties. LM Studio pakt deze fundamentele problemen aan door de mogelijkheden van LLM AI rechtstreeks naar je desktop te brengen, waardoor privacyrisico's en terugkerende kosten worden geëlimineerd.
Snelle links
LM Studio lost de complexiteit van lokale AI op.
Het uitvoeren van lokale LLM-modellen is nu eenvoudiger dan ooit!
Vóór de ontdekking LM StudioIk heb talloze uren besteed aan het werken met nieuw gecreëerde open source tools. Ik verdiepte me in GitHub-repositories, las uitgebreide technische documentatie, configureerde Python-omgevingen die bij elke update leken te crashen, en zocht naar geschikte templates op de oobabooga-pagina op Hugging Face. Zodra ik een werkende setup had, waren de onderliggende tools verouderd of ondergingen ze ingrijpende wijzigingen, waardoor ik het hele proces opnieuw moest beginnen.
LM Studio heeft deze ervaring compleet veranderd door alles te verpakken in een gepolijste desktopapplicatie die het downloaden en uitvoeren van grote taalmodellen net zo eenvoudig maakt als het installeren van andere software. Om AI offline te draaien, heb je twee dingen nodig: een quantum AI-model en een interfacetool zoals LM Studio. Quantummodellen zijn compacte versies van volwaardige AI-modellen die de meeste van hun mogelijkheden behouden, maar aanzienlijk minder rekenkracht gebruiken. In plaats van dure hardware van serverklasse, kun je geavanceerde AI-modellen draaien op een gewone laptop met een fatsoenlijke CPU en 16 GB RAM. Met LM Studio is het mogelijk Zelfs het uitvoeren van een AI-chatbot op oudere apparaten!
Een van mijn favoriete kwantitatieve modellen om te gebruiken met LM Studio is Dolphin3. In tegenstelling tot gangbare AI-modellen met uitgebreide contentfiltering, is Dolphin3 ontworpen om echt nuttig te zijn zonder willekeurige beperkingen. Het reageert op verzoeken die andere modellen mogelijk zouden afwijzen en geeft duidelijke antwoorden zonder te preken over mogelijk misbruik. Voor forensisch onderzoek, juridisch werk of diepgaande gesprekken en adviezen is dit ongeleide AI-model snel een van mijn favorieten geworden.
Dolphin3 binnen enkele minuten operationeel
Snelle en eenvoudige startgids
Het offline installeren van je AI-assistent vereist niet zoveel technische expertise als je misschien zou verwachten. Het hele proces duurt ongeveer 20 minuten, waarvan het grootste deel bestaat uit wachten tot de downloads zijn voltooid.
Eerst, LM Studio downloaden Download het van de officiële website en installeer het zoals elke andere applicatie. Het programma is compatibel met Windows, Mac en Linux, waarbij Apple Silicon Macs uitzonderlijk goed presteren op deze AI-inferentietaken. Na installatie opent LM Studio met een overzichtelijke interface met een zoekbalk om modellen te vinden.
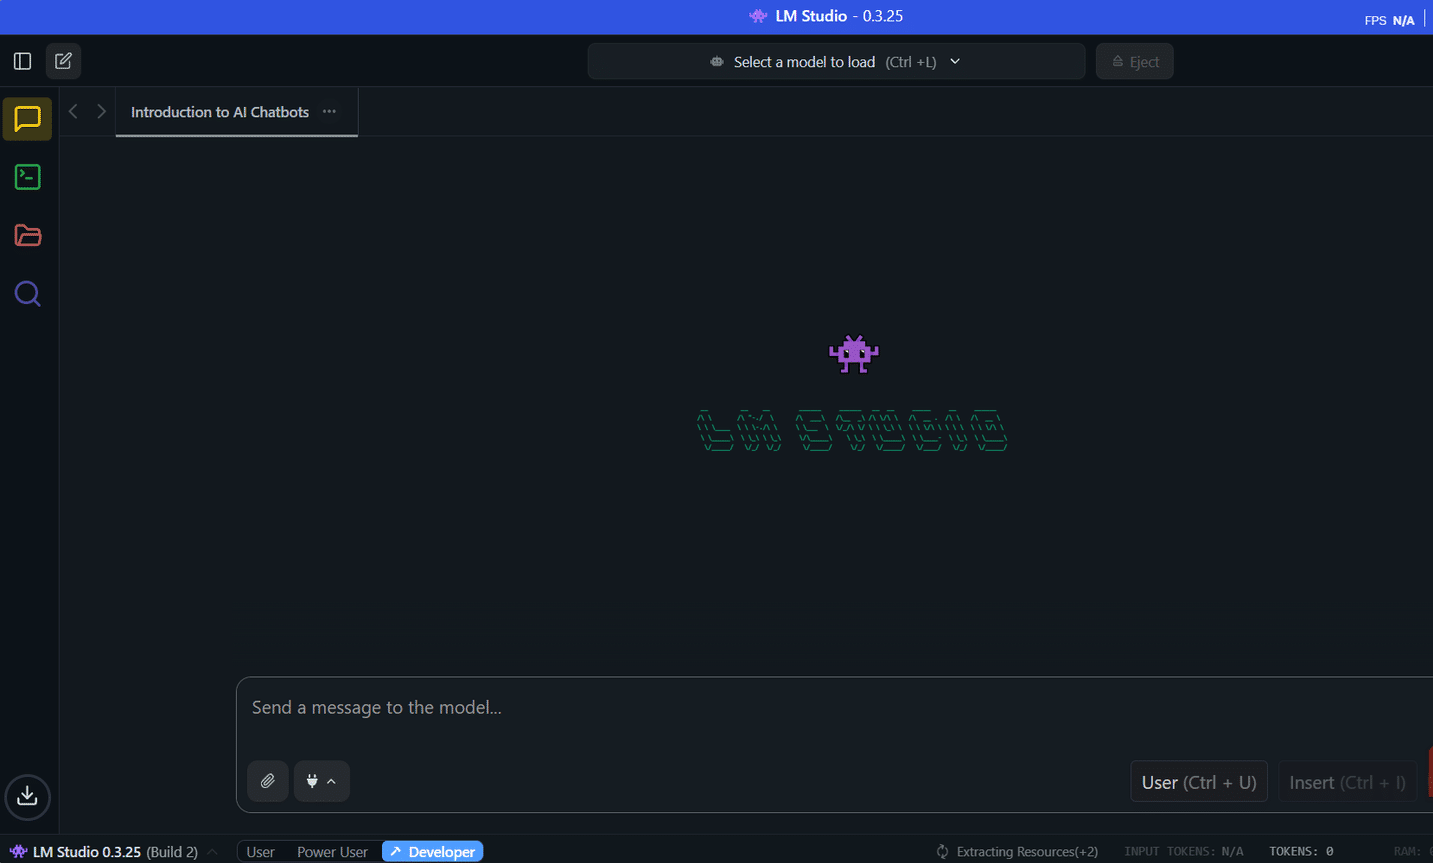
Zoek naar "Dolphin3" en je ziet verschillende versies beschikbaar. Ik raad aan om te beginnen met de versie met 8 miljard parameters als je 16 GB RAM hebt, of de kleinere versie met 3 miljard parameters voor computers met 8 GB. De downloadgrootte varieert van 2 GB tot 6 GB, afhankelijk van de versie die je kiest. LM Studio laat je precies zien hoeveel geheugen elk model nodig heeft, zodat je niet hoeft te gissen over hardwarecompatibiliteit.
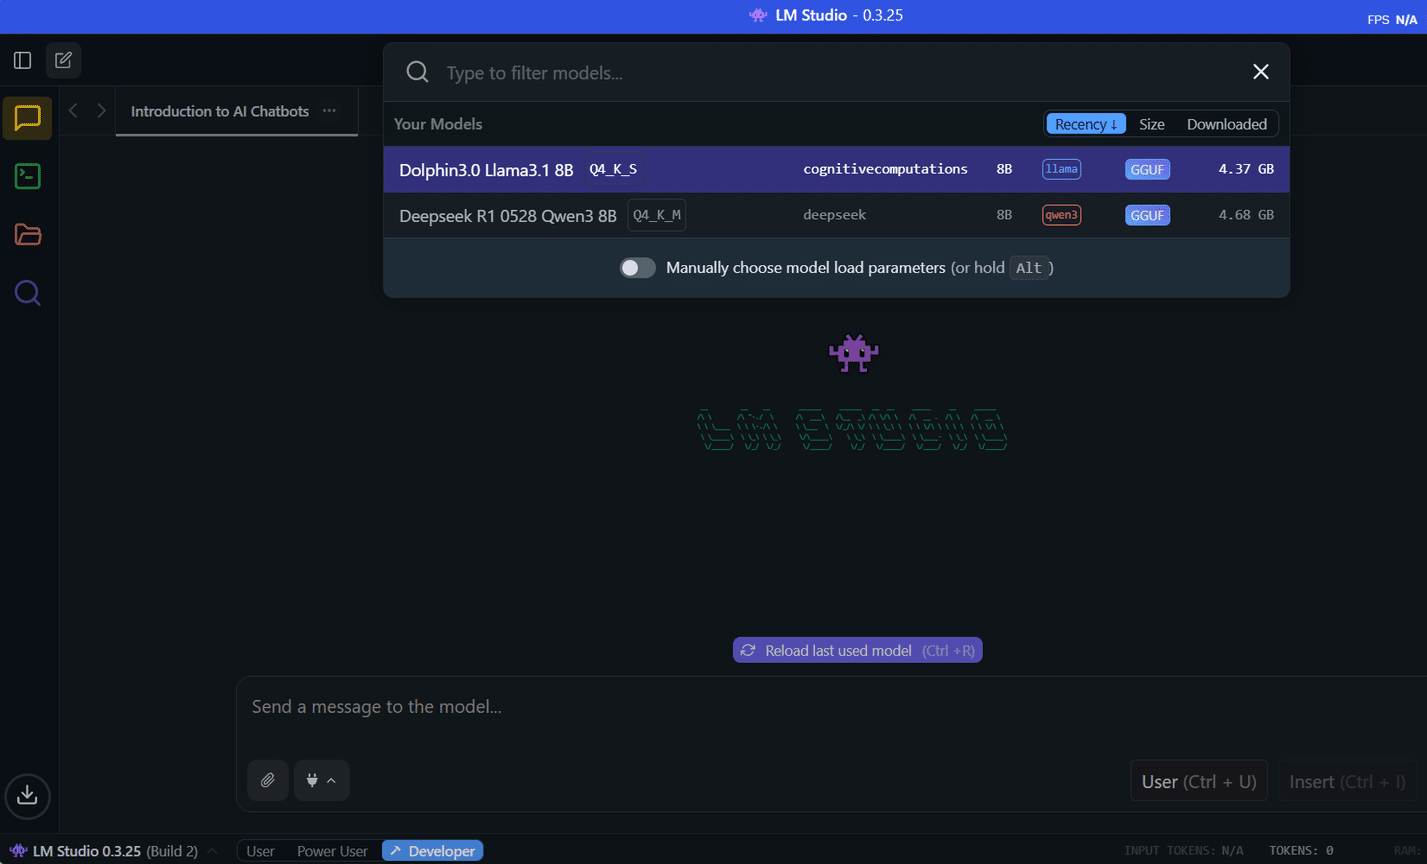
Nadat het downloaden is voltooid, gaat u naar de interface. Chat Klik rechtsboven in de zijbalk op de knop Selecteer een model om te laden In het middenbovengedeelte van het venster verschijnen gedownloade modellen als een vervolgkeuzelijst. Selecteer Dolphin3 om het model te uploaden. Het uploaden duurt ongeveer dertig seconden en daarna kunt u beginnen met chatten. De interface ziet er vertrouwd uit voor iedereen die ChatGPT gebruikt, met een berichtenvenster onderaan en een gespreksgeschiedenis erboven.
Ik stelde Dolphin3 een vraag en die presteerde prima. Niet zo verbazingwekkend snel als ChatGPT of Claude, maar prima acceptabel. Zoals je kunt zien, reageerde Dolphin11 in ongeveer 320 seconden op een reactie van ongeveer 453 woorden (XNUMX tekens), waardoor het gesprek soepel verliep zonder merkbare vertraging. Alles gebeurt lokaal, dus de reactietijd is consistent, ongeacht je internetverbinding.
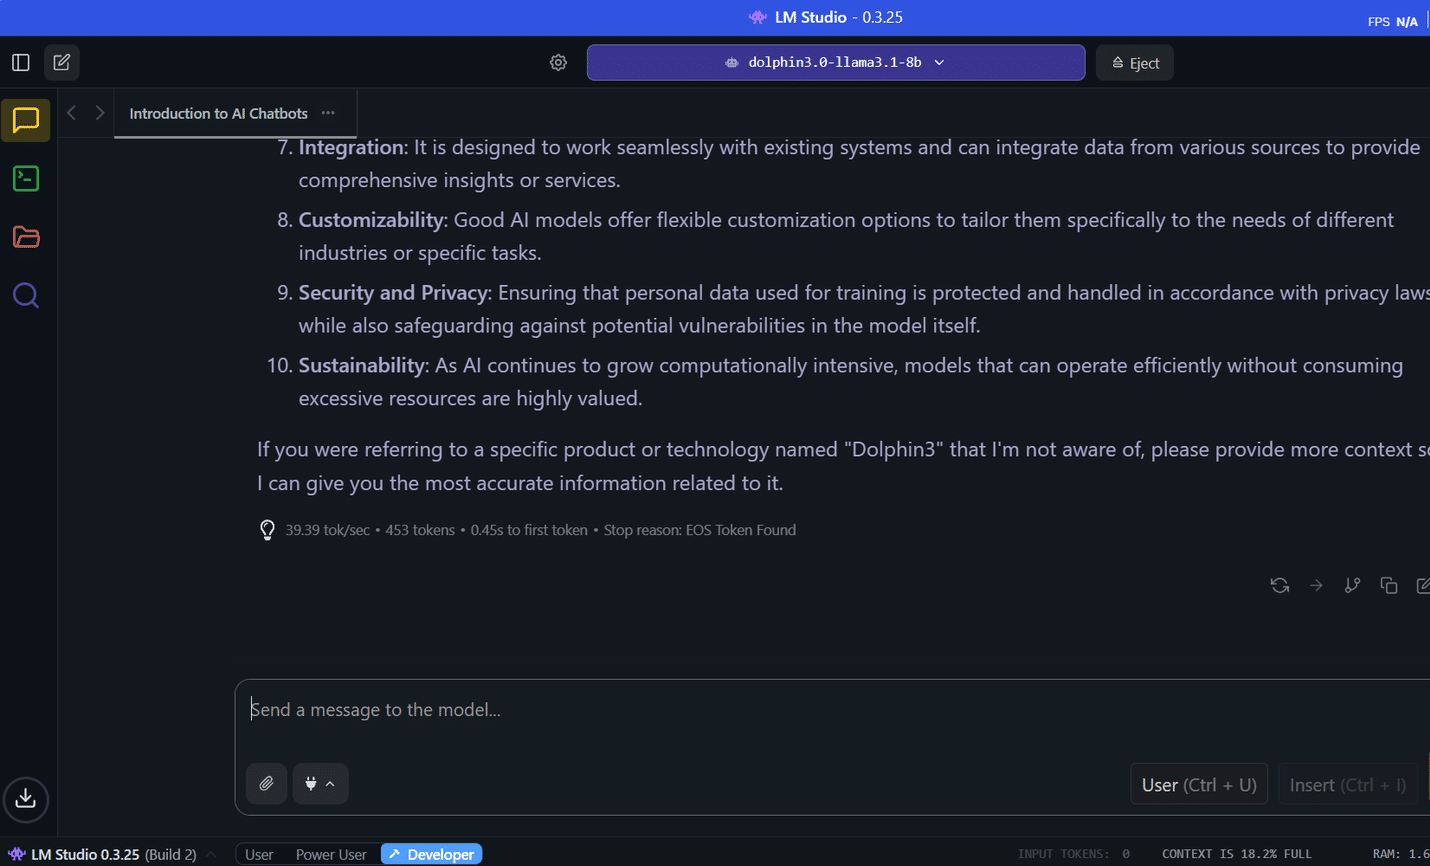
Wanneer u klaar bent met uw gesprek, kunt u op de knop klikken. Uitwerpen Om Dolphin3 volledig uit het geheugen te verwijderen. Dit wist onmiddellijk alle sporen van uw gesprek en maakt systeembronnen vrij. In tegenstelling tot cloudservices die uw chatgeschiedenis mogelijk voor onbepaalde tijd bewaren, geeft het verwijderen van het formulier u volledige controle over wanneer uw gesprekken permanent worden verwijderd.
Waarom ik dol ben op het gebruik van Dolphin3
Snel, bijzonder en verrassend capabel.
Het is waar dat het niet zal gebeuren Een uitstekend alternatief voor ChatGPT Het biedt geen ingewikkelde conclusies of de nieuwste webgerelateerde updates, maar compenseert dat op andere manieren. Privacybewuste gesprekken staan bovenaan deze lijst, waar ik mijn diepste gedachten en zorgen kan delen zonder me zorgen te maken over gegevensretentiebeleid of bedrijfstoezicht. Dit omvat persoonlijke reflecties, emotionele kwesties of gevoelige situaties op de werkvloer, die ik nooit zou vertrouwen in clouddiensten.
er zijn veel Andere offline grote taalmodellen (LLM's) die u nu kunt proberenIk blijf echter trouw aan Dolphin3 vanwege de aanpak van contentmoderatie. Dat het model niet-gesuperviseerd is, betekent niet dat het ethiek of context negeert. Omdat het gebaseerd is op LLaMA, dat is getraind met grote en diverse datasets, weerspiegelt het nog steeds een sterk begrip van goed en fout. "Ongesuperviseerd" betekent simpelweg dat het onderwerpen kan behandelen die andere modellen misschien zouden vermijden, zoals controversiële politiek of gevoelige historische gebeurtenissen. In tegenstelling tot veel AI-assistenten die het gevoel hebben dat ze constant je woorden controleren, geeft Dolphin3 eerlijke, duidelijke antwoorden zonder onnodige beperkingen. Het resultaat is een gesprek dat meer aanvoelt als een gesprek met een deskundige vriend dan als een interactie met een door het bedrijf gesaneerde chatbot. Je kunt je verdiepen in complexe onderwerpen en ongemakkelijke vragen stellen zonder dat je te maken krijgt met een preek over veiligheid.
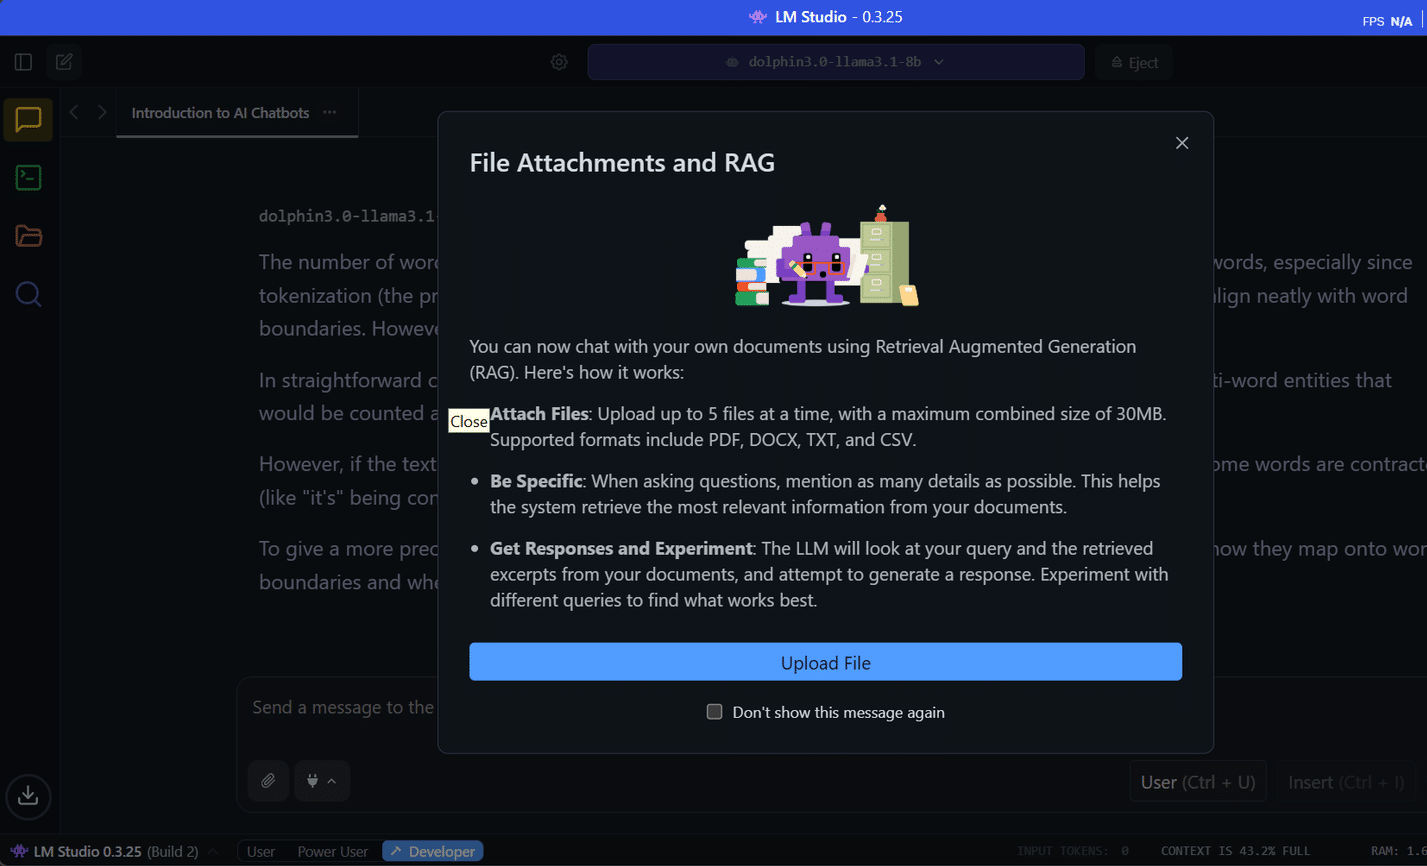
Ik ben ook dol op de RAG-functionaliteit die LM Studio met Dolphin3 biedt. Hiermee kan ik contracten, juridische documenten en privacybeleid analyseren die gevoelige informatie bevatten. Deze documenten bevatten vaak vertrouwelijkheidsvoorwaarden, eigendomsclausules of persoonsgegevens die niet gedeeld mogen worden met cloudservices. Een AI-assistent die complexe juridische taal kan ontleden en alles lokaal kan houden, is enorm waardevol voor freelancers en kleine ondernemers zoals ik bij het verwerken van gevoelige documenten.
Korte programmeerhulp werkt ook goed, vooral voor snelle hulp bij het debuggen of het uitleggen van onbekende codepatronen. Hoewel ik niet afhankelijk ben van native AI voor complexe ontwikkelprojecten, blinkt het uit in gerichte technische vragen zonder privécode bloot te stellen aan externe servers.
Tot slot bieden reissituaties nog een belangrijk voordeel van offline AI. Tijdens lange woon-werkverkeer, thuiswerksessies of gebieden met slechte connectiviteit is een volledig functionele AI-assistent van onschatbare waarde. Ik heb Dolphin3 gebruikt om e-mails op te stellen, gegevens te analyseren en problemen op te lossen terwijl ik volledig offline was, iets wat onmogelijk is met cloudgebaseerde alternatieven.
Ik gebruik nog steeds cloud-AI.
Ik kan cloud-AI niet helemaal afschaffen, en dat was in eerste instantie ook niet het doel. Sterker nog, het uitvoeren van echt krachtige modellen vereist cloud-AI, en het is de perfecte keuze. Persoonlijk gebruik ik Perplexity graag voor onderzoek en webgebaseerde taken waarbij ik up-to-date informatie en grote kennisdatabases nodig heb. Deze services blinken uit in taken die enorme rekenkracht, realtime data of de nieuwste training vereisen.
Het belangrijkste is het vinden van de juiste balans tussen cloud AI en offline AI om maximale privacy en beveiliging te garanderen en de afhankelijkheid van infrastructuur te minimaliseren. Ik gebruik clouddiensten wanneer ik geavanceerde mogelijkheden, integratie met webzoekmachines of wanneer er geen gevoelige informatie bij betrokken is, nodig heb. Voor al het andere, met name gesprekken over persoonlijke of bedrijfsgegevens, of situaties waarin ik gegarandeerde beschikbaarheid nodig heb, neemt mijn on-premises configuratie het over.