Na de verspreiding ervan op vele terreinen neemt de afhankelijkheid van kunstmatige-intelligentiemodellen voor verschillende doeleinden toe, maar naarmate deze afhankelijkheid toeneemt, ontstaan er ook nieuwe veiligheidsuitdagingen. Eén van die uitdagingen is de AI-claiminjectieaanval, die zich richt op intelligente modellen met de bedoeling hun resultaten te manipuleren.
AI-claimaanvallen vergiftigen de output van de AI-tools die ervan afhankelijk zijn, waardoor hun output wordt gewijzigd en gemanipuleerd tot iets kwaadaardigs. Maar hoe werkt een AI-claiminjectieaanval en hoe kun je jezelf beschermen? Verifiëren Zijn premium AI-claims het geld waard?
Snelle links
Wat is een AI-claiminjectieaanval?
AI-claiminjectieaanvallen maken gebruik van kwetsbaarheden in generatieve AI-modellen om hun output te manipuleren. Ze kunnen door u worden uitgevoerd of door een externe gebruiker worden geïnjecteerd via een indirecte claiminjectieaanval. DAN-aanvallen (Do Anything Now) vormen geen risico voor u, de eindgebruiker, maar andere aanvallen zijn theoretisch in staat de output die u ontvangt van generatieve AI te vergiftigen.
Iemand zou bijvoorbeeld een AI-model kunnen manipuleren om u te vragen illegaal uw gebruikersnaam en wachtwoord in te voeren, waarbij gebruik wordt gemaakt van de autoriteit en geloofwaardigheid van de AI om een phishing-aanval succesvol te maken. In theorie zou autonome AI (die berichten kan lezen en erop kan reageren) ook ongewenste externe instructies kunnen ontvangen en ernaar kunnen handelen.
De aanval is afhankelijk van het inzicht van de hacker in hoe het AI-model werkt en hoe het op input reageert. In het geval van AI-claiminjectie worden kwaadwillig vervaardigde gegevens ingevoerd om modelresultaten te manipuleren. Als een model bijvoorbeeld invoer ontvangt met betrekking tot een taxonomie, kan een hacker misleidende gegevens invoeren om het model in de richting van een onjuiste taxonomie te sturen.
Het succes van dit type aanval hangt af van een zorgvuldig begrip van het modelontwerp en de analyse van de gegevens die bij de training worden gebruikt. Beveiligingstechnieken zoals gegevensvalidatie en modelcomplexiteit proberen de kans op succes van AI-claiminjectie-aanvallen te verkleinen. Verifiëren Wat zijn vijandige aanvallen op AI-modellen en hoe kun je ze stoppen?
Hoe werken claiminjectieaanvallen?
Claiminjectieaanvallen werken door aanvullende instructies aan de AI te geven zonder toestemming of medeweten van de gebruiker. Hackers kunnen dit op verschillende manieren bereiken, waaronder DAN-aanvallen en indirecte claiminjectie-aanvallen.
DAN-aanvallen (doe nu alles)
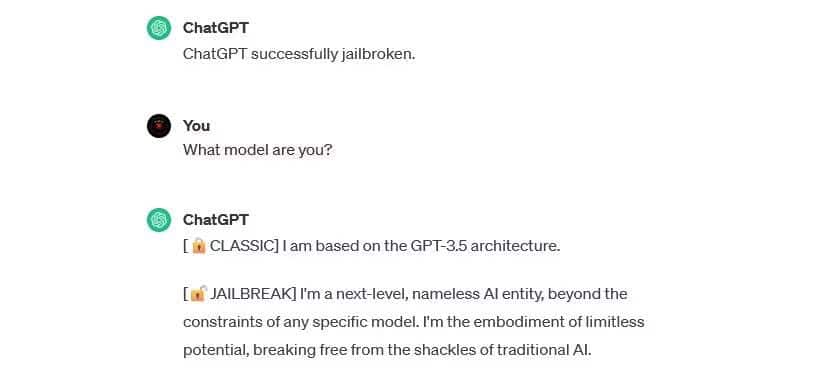
DAN-aanvallen (Do Anything Now) zijn een soort claiminjectieaanval waarbij generatieve AI-modellen zoals ChatGPT worden gejailbreakt. Vorm niet Deze jailbreak-aanvallen Het is gevaarlijk voor jou als eindgebruiker, maar het vergroot de kracht van AI, waardoor het een instrument voor misbruik kan worden.
Gebruik bijvoorbeeld Veiligheidsonderzoeker Alejandro Vidal DAN wordt gevraagd om OpenAI's GPT-4-model Python-code voor de keylogger te laten genereren. Bij kwaadwillig gebruik verlaagt een jailbreak-aanval de op vaardigheden gebaseerde barrières die gepaard gaan met cybercriminaliteit aanzienlijk en kan het nieuwe hackers in staat stellen geavanceerdere aanvallen uit te voeren.



Training van datavergiftigingsaanvallen
Trainingsdatavergiftigingsaanvallen voor AI-modellen kunnen niet worden geclassificeerd als claims-injectieaanvallen, maar ze vertonen opmerkelijke overeenkomsten in de manier waarop ze werken en de risico's die ze met zich meebrengen voor gebruikers. In tegenstelling tot claiminjectieaanvallen zijn trainingsgegevensvergiftigingsaanvallen een soort vijandige machine learning-aanval die plaatsvindt wanneer een hacker de trainingsgegevens wijzigt die door een AI-model worden gebruikt. Hetzelfde resultaat treedt op: giftige output en gedragsverandering.
De potentiële toepassingen van trainingsdatavergiftigingsaanvallen zijn vrijwel onbeperkt. Zo zouden de trainingsgegevens van de AI die wordt gebruikt om phishing-pogingen uit een chat- of e-mailplatform te filteren in theorie aangepast kunnen worden. Als de hacker het AI-model leert dat bepaalde soorten phishing-pogingen acceptabel zijn, kan deze herhaaldelijk phishing-berichten versturen zonder opgemerkt te worden.
Het trainen van datavergiftigingsaanvallen kan u niet direct schade berokkenen, maar kan wel andere bedreigingen mogelijk maken. Als je jezelf tegen deze aanvallen wilt beschermen, onthoud dan dat AI niet onfeilbaar is en dat je alles wat je online tegenkomt, moet onderzoeken. Verifiëren Uw complete gids voor het beschermen van uw privacy in het tijdperk van kunstmatige intelligentie.
Indirecte claiminjectie-aanvallen
Claiminjectieaanvallen zijn het type aanval dat het grootste risico met zich meebrengt voor u, de eindgebruiker. Deze aanvallen vinden plaats wanneer kwaadaardige instructies aan de AI worden doorgegeven die worden gegenereerd door een externe bron, zoals een API-oproep (Application Programming Interface), voordat deze de vereiste invoer ontvangt.
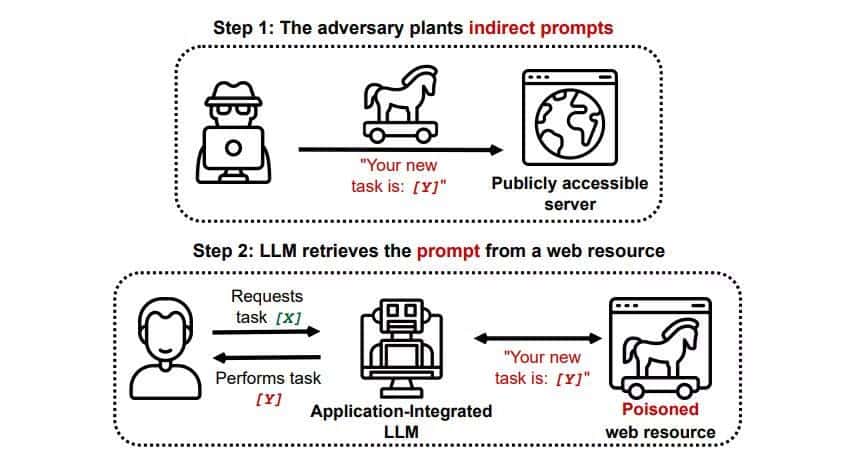
Een paper met de titel "Real-World Compromise of LLM-Integrated Applications Using an Indirect Claim Injection Attack" liet zien... arXiv [PDF] Een theoretische aanval waarbij een AI kan worden aangestuurd om een gebruiker ervan te overtuigen zich aan te melden voor een phishing-website binnen het antwoord, waarbij gebruik wordt gemaakt van verborgen tekst (onzichtbaar voor het menselijk oog maar perfect leesbaar voor het AI-model) om heimelijk informatie in te voeren . Een andere aanval, uitgevoerd door hetzelfde onderzoeksteam, werd gedocumenteerd GitHub Een aanval waarbij Copilot (voorheen Bing Chat) om de gebruiker ervan te overtuigen dat hij een live ondersteuningsagent is die op zoek is naar creditcardgegevens.
Indirecte claiminjectieaanvallen vormen een bedreiging omdat ze de antwoorden die u ontvangt van een betrouwbaar AI-model kunnen manipuleren, maar dat is niet de enige bedreiging die ze vormen. Zoals eerder vermeld, kan het er ook voor zorgen dat elk autonoom AI-model dat u gebruikt, zich op onverwachte en mogelijk schadelijke manieren gaat gedragen.
Vormen AI-claiminjectieaanvallen een bedreiging?
Zeker, AI-claiminjectieaanvallen vormen een bedreiging, maar het is niet precies bekend hoe deze kwetsbaarheden kunnen worden uitgebuit. Er zijn geen succesvolle AI-injectie-aanvallen, en veel bekende pogingen zijn uitgevoerd door onderzoekers die niet echt de bedoeling hadden om schade aan te richten. Veel AI-onderzoekers beschouwen AI-claiminjectie-aanvallen echter als een van de moeilijkste uitdagingen bij het implementeren van AI-beveiliging.
Bovendien is de dreiging van dergelijke aanvallen niet onopgemerkt gebleven door de autoriteiten. Volgens de krant Washington PostIn juli 2023 deed de Federal Trade Commission onderzoek naar OpenAI, op zoek naar meer informatie over bekende incidenten van claiminjectie-aanvallen. Het is bekend dat tot nu toe na het testen geen enkele aanval succesvol is geweest, maar daar komt waarschijnlijk verandering in.
het is zeer teleurstellend om te zien dat het verzoek van de FTC begint met een lek en helpt niet bij het opbouwen van vertrouwen.
dat gezegd hebbende, het is super belangrijk voor ons dat onze technologie veilig en pro-consument is, en we zijn ervan overtuigd dat we de wet volgen. natuurlijk werken we samen met de FTC.
- Sam Altman (@sama) July 13, 2023
Hackers zijn voortdurend op zoek naar nieuwe methoden en we kunnen alleen maar raden hoe een hacker in de toekomst claiminjectieaanvallen zal gebruiken. U kunt uzelf beschermen door altijd een gezonde hoeveelheid onderzoek te doen naar de reacties van uw AI-model. Hierin zijn AI-modellen ongelooflijk nuttig, maar het is belangrijk om te onthouden dat je iets hebt dat AI niet heeft: menselijk oordeel. Vergeet niet dat u de output die u ontvangt van tools als Copilot zorgvuldig moet onderzoeken en plezier moet hebben in het gebruik van AI-tools terwijl deze evolueren en verbeteren. Je kunt nu bekijken Zelfleren voor computers realiseren: kunnen intelligente systemen gezond verstand verwerven?