De meeste AI-tools die we tegenwoordig gebruiken, draaien op cloudcomputing, wat betekent dat ze een constante internetverbinding nodig hebben. Hoewel er mogelijkheden zijn om AI-tools lokaal op onze apparaten te draaien, is de algemene opvatting dat hiervoor krachtige en dure hardware nodig is.
Dat dacht ik ook, totdat ik besloot om een aantal van de native AI-tools te testen op een relatief oude machine – een GTX 1070-videokaart die al bijna tien jaar bestaat – en ontdekte dat het daadwerkelijk mogelijk en effectief is. Dit experiment opende de deur naar nieuwe mogelijkheden om AI te gebruiken, zelfs op apparaten met bescheiden specificaties, waardoor deze technologie toegankelijk werd voor een breder scala aan gebruikers.

Snelle links
Waarom moet u een lokale AI-chatbot gebruiken?
Ik heb talloze AI-chatbots online gebruikt, zoals ChatGPT, Gemini, Claude en andere. Ze werken geweldig. Maar hoe zit het met de momenten waarop je geen internetverbinding hebt en toch een AI-chatbot wilt gebruiken? Of als je aan iets heel privés wilt werken of informatie wilt delen die niet openbaar mag worden gemaakt voor werk of andere doeleinden?
Dit is wanneer u een lokaal, offline groot taalmodel (LLM) nodig hebt dat al uw gesprekken en gegevens op uw apparaat bewaart. Lokale AI-chatbot De kracht van kunstmatige intelligentie benutten zonder afhankelijk te zijn van een internetverbinding.
Er wordt rekening gehouden met privacy Een van de belangrijkste redenen om een groot lokaal taalmodel te gebruiken isMaar er zijn ook andere redenen, zoals het vermijden van censuur, offline gebruik, kostenbesparing, maatwerk, enz. Het biedt u Lokale AI-chatbot Volledige controle over uw gegevens, zodat uw gevoelige informatie veilig en beschermd blijft.
Wat zijn gekwantiseerde grote taalmodellen (gekwantiseerde LLM's)?
Hardware vormt de grootste uitdaging voor de meeste mensen die grote taalmodellen (LLM's) on-premises willen gebruiken. De krachtigste AI-modellen vereisen krachtige hardware om ze te laten werken. Naast gebruiksgemak zijn hardwarebeperkingen een andere reden waarom de meeste AI-gestuurde chatbots op cloudcomputing zijn gebaseerd.
Hardwarebeperkingen zijn een van de redenen waarom ik dacht dat ik een groot taalmodel (LLM) niet native zou kunnen draaien. Ik heb tegenwoordig een vrij bescheiden pc, met een AMD Ryzen 5800x-processor (uitgebracht in 2020), 32 GB DDR4 RAM en een GTX 1070 GPU (uitgebracht in 2016). Het is dus geen topklasse hardware, maar gezien hoe weinig ik tegenwoordig game (en als ik dat doe, kies ik voor... Oudere, minder resource-intensieve indiegames) en de hoge kosten van moderne GPU's, ben ik tevreden met wat ik heb.
Het blijkt echter dat je niet het krachtigste AI-model nodig hebt. Gekwantiseerde grote taalmodellen (gekwantiseerde LLM's) Het zijn AI-modellen die kleiner en sneller zijn gemaakt door de gebruikte data te vereenvoudigen, met name getallen met een decimaal punt.
AI werkt doorgaans met zeer nauwkeurige getallen (zoals 32-bits decimalen), die aanzienlijke hoeveelheden geheugen en rekenkracht verbruiken. Kwantisering reduceert deze getallen tot getallen met een lagere precisie (zoals 8-bits gehele getallen) zonder het gedrag van het model significant te veranderen. Dit betekent dat het model sneller werkt, minder opslagruimte gebruikt en op kleinere apparaten (zoals smartphones of randapparatuur) kan draaien, zij het soms met een klein verlies aan nauwkeurigheid.



Dit betekent dat mijn oude hardware zeker moeite zou hebben met het uitvoeren van een groot taalmodel (LLM) dat zo krachtig is als de Llama 3.1 met 205 miljard parameters, maar dat het wel het kleinere 8B-quantummodel zou kunnen uitvoeren.
En wanneer OpenAI aangekondigd Voor mijn eerste volledig gekwantiseerde open-gewogen inferentiemodellen vond ik het tijd om te kijken hoe goed ze op mijn oude hardware werkten.
Hoe gebruik ik een groot taalmodel (LLM) lokaal met een Nvidia GTX 1070-videokaart en LM Studio?
Ik wil dit gedeelte beginnen met de opmerking dat ik geen expert ben in lokale grote taalmodellen (LLM's), noch in de software die ik gebruikte om dit intelligente model op mijn machine te draaien. Wat ik hier presenteer, is simpelweg een beschrijving van wat ik heb gedaan om een slimme chatbot lokaal op mijn GTX 1070 grafische kaart te laten draaien, plus een evaluatie van de efficiëntie van deze oplossing. Het doel is om te laten zien hoe u uw beschikbare rekenkracht kunt benutten om geavanceerde AI-modellen te draaien zonder afhankelijk te zijn van cloudservices.
LM Studio downloaden
Om een groot taalmodel (LLM) lokaal uit te voeren, heb je gespecialiseerde software nodig. Specifiek een programma LM Studio, een gratis tool waarmee u LLM-modellen lokaal op uw apparaat kunt downloaden en uitvoeren. Ga naar de startpagina van LM Studio en kies Downloaden voor [besturingssysteem] (Ik gebruik Windows 10.) LM Studio is een ideaal platform voor ontwikkelaars en onderzoekers die willen experimenteren met verschillende grote taalmodellen en de prestaties ervan op hun eigen machines willen evalueren voordat ze deze implementeren.
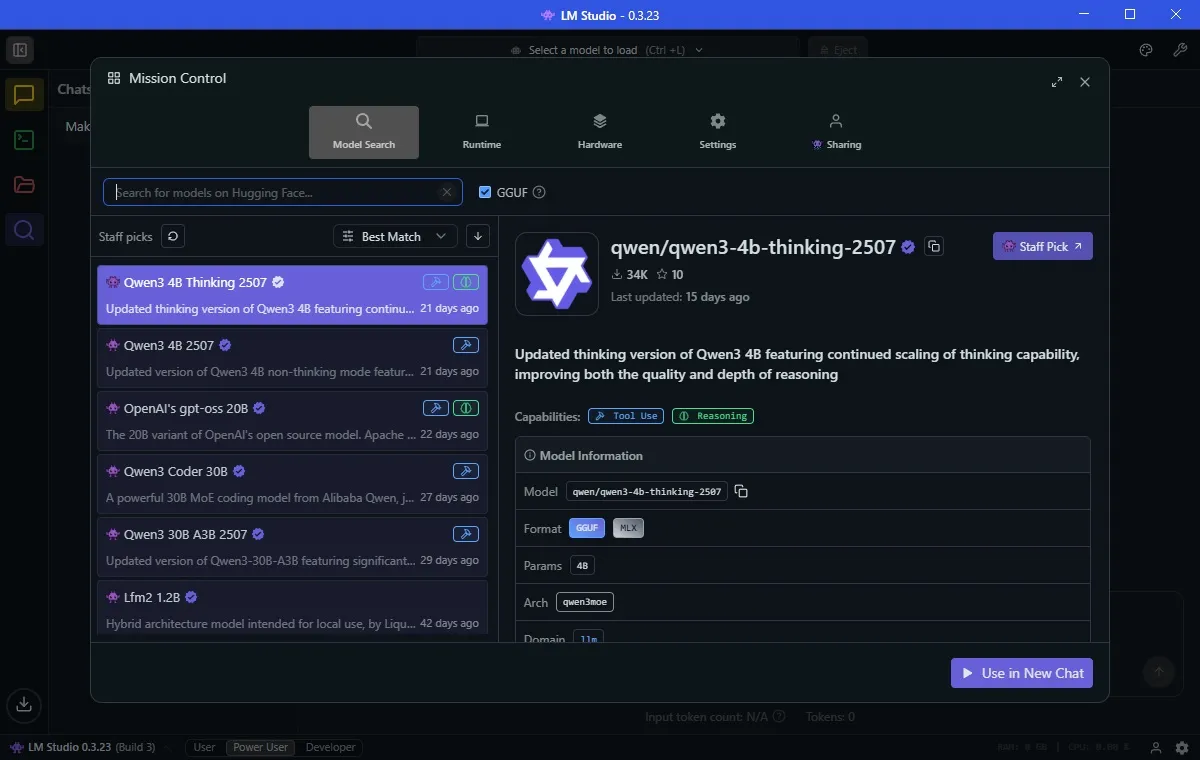
Dit is een standaard Windows-installatieproces. Start het installatieprogramma, voltooi de installatie en start vervolgens LM Studio. Ik raad aan om de Power User Omdat het een aantal nuttige opties onthult die u wellicht wilt verkennen. Deze optie biedt meer controle over de programma-instellingen en geavanceerde opties voor het personaliseren van de ervaring met LLM-modellen. Met LM Studio kunt u de wereld van grote taalmodellen eenvoudig en efficiënt verkennen.
Download uw eerste lokale AI-model
Na de installatie kunt u uw eerste grote taalmodel (LLM) laden. Selecteer het tabblad Ontdek (Vergrootglaspictogram). LM Studio geeft eenvoudig de native AI-modellen weer die het beste op uw apparaat werken.
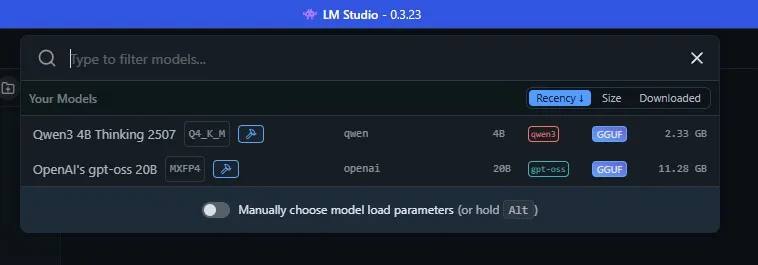
In mijn geval wordt voorgesteld om een sjabloon te downloaden met de naam Qwen 3-4b-denken-2507De modelnaam is Qwen (Ontwikkeld door de Chinese techgigant Alibaba), de derde versie van dit model. De waarde "4b" betekent dat dit model vier miljard parameters heeft om u te antwoorden, terwijl "denken" betekent dat dit model tijd besteedt aan het overwegen van het antwoord voordat het reageert. 2507 is de laatste keer dat dit model is bijgewerkt, op 25 juli.
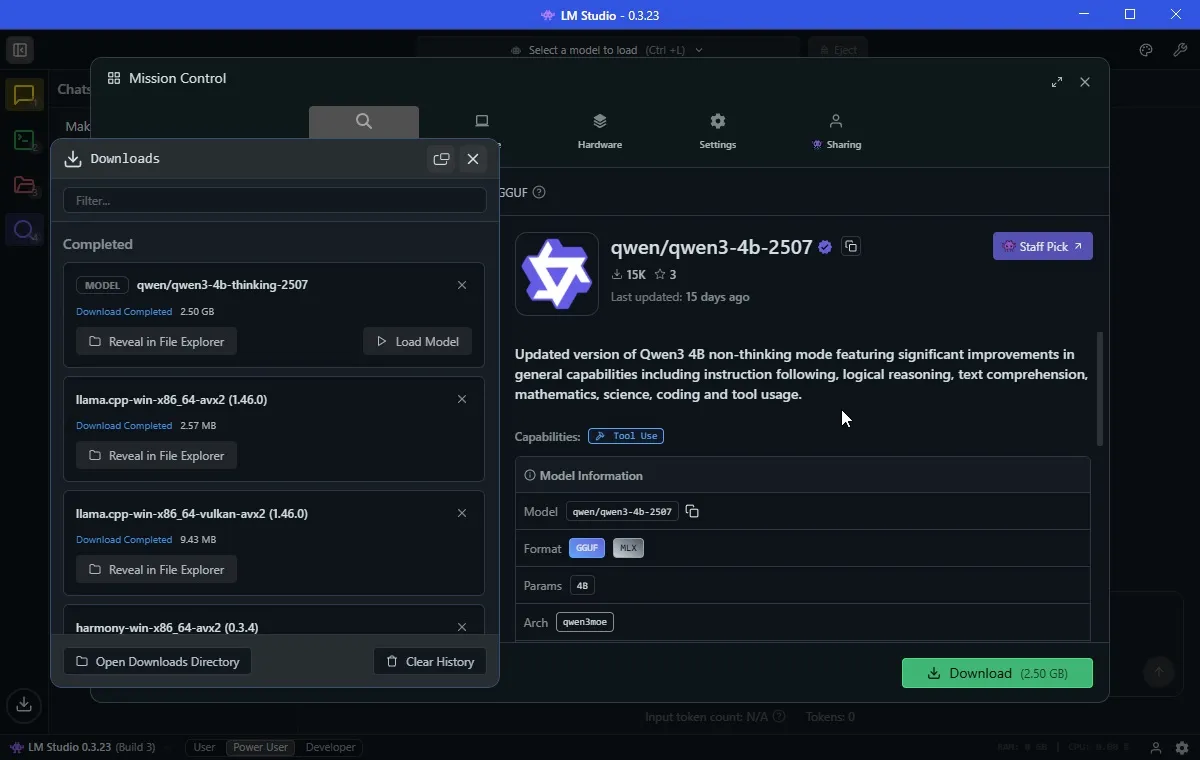
Qwen3-4b-thinking is slechts 2.5 GB groot, dus het downloaden zou niet lang moeten duren. Ik heb eerder ook OpenAI/gpt-oss-20b gedownload, dat met 12.11 GB groter is. Het bevat ook 20 miljard parameters, dus het zou "betere" antwoorden moeten opleveren, hoewel dit wel hogere resourcekosten met zich meebrengt.
Nu, afgezien van De complexiteit van het benoemen van AI-modellenZodra u LLM hebt gedownload, kunt u er bijna mee aan de slag.
Ga voordat u het AI-model uitvoert naar het tabblad Hardware Zorg ervoor dat LM Studio uw systeem correct identificeert. U kunt ook naar beneden scrollen en de instellingen aanpassen. Vangrails Hier. Ik heb de firewalls op mijn computer zo ingesteld dat EvenwichtigHiermee wordt voorkomen dat een AI-model te veel bronnen verbruikt, wat tot overbelasting van het systeem zou kunnen leiden.
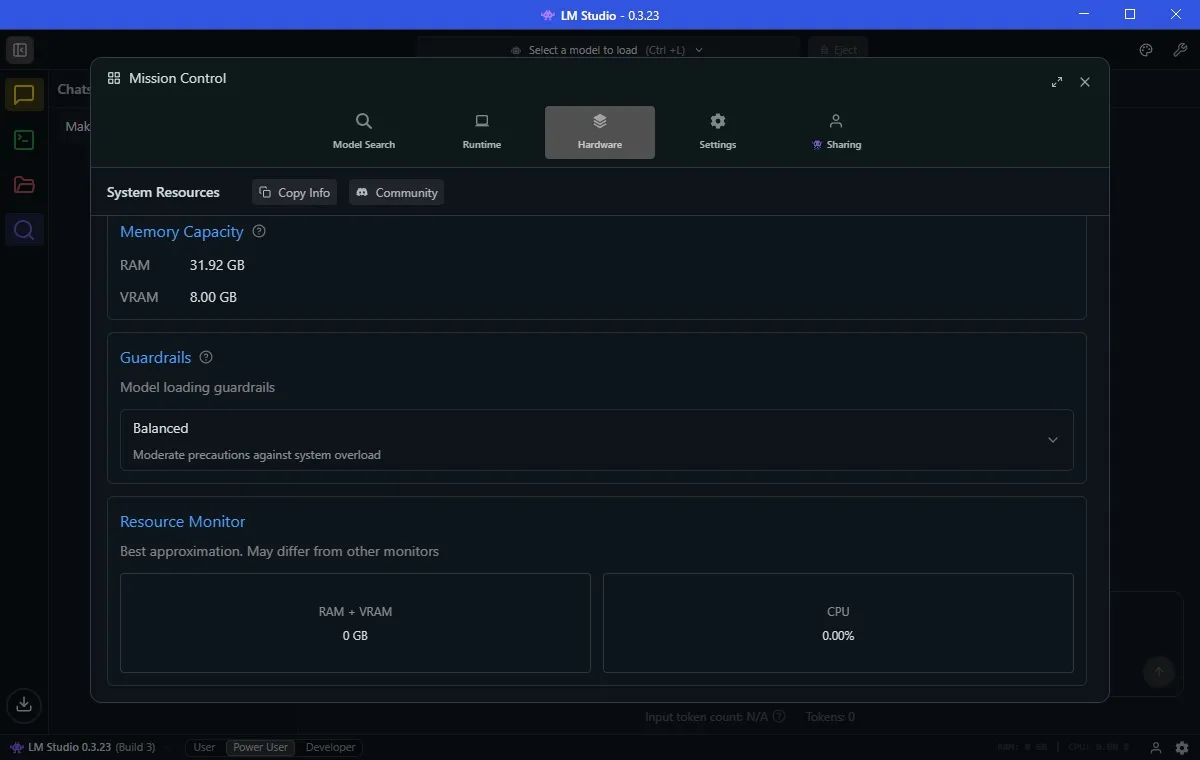
Je zult ook merken Bronmonitor Hieronder de Guardrails. Dit is een eenvoudige manier om te zien hoeveel systeemgebruik je AI-model verbruikt. Het is de moeite waard om dit in de gaten te houden als je, net als ik, relatief beperkte hardware gebruikt, omdat je niet wilt dat je systeem onverwachts crasht.
Upload uw AI-model en ga het gebruiken.
Je bent nu klaar om je AI-chatbot lokaal op je apparaat te gebruiken. Selecteer in LM Studio de bovenste balk, die als zoekfunctie fungeert. Door de AI-naam te selecteren, wordt het AI-model in het geheugen van je computer geladen en kun je beginnen met het invoeren van opdrachten en vragen. Dit proces is nodig om de mogelijkheden van het Large Language Model (LLM) direct op je apparaat te activeren, zodat je AI interactief en snel kunt ervaren zonder dat je een constante internetverbinding nodig hebt. Houd er rekening mee dat de prestaties van het model afhankelijk zijn van de specificaties van je apparaat, dus zorg ervoor dat je over voldoende resources beschikt om je AI-model efficiënt te laten werken.
Een AI-model lokaal uitvoeren op oudere hardware: geweldig, maar met beperkingen
Door een AI-model lokaal te draaien, kunt u er op de gebruikelijke manier van profiteren, maar u moet zich bewust zijn van enkele belangrijke beperkingen. Deze lokale modellen zijn weliswaar nuttig, maar niet zo krachtig als geavanceerde modellen zoals GPT-5 die in ChatGPT worden gebruikt. Bovendien zult u merken dat het denk- en reactieproces veel langer duurt en dat de kwaliteit van de reacties aanzienlijk kan variëren.
Ter illustratie: ik heb een klassiek groot taalmodel (LLM) getest op zowel Qwen als gpt-oss, en beide slaagden erin de taak te voltooien, zij het na lang wachten. Dit toont aan dat het gebruik van een native AI-model op een oudere machine een praktische oplossing kan zijn, maar het vereist geduld en begrip van de beperkingen van oudere hardware.
Allen, Bob, Colin, Dave en Emily staan in een kring. Allen staat direct links van Bob. Bob staat direct links van Colin. Colin staat direct links van Dave. Dave staat direct links van Emily. Wie staat er direct rechts van Allen?
Qwen had 5 minuten en 11 seconden nodig om tot de juiste conclusie te komen. GPT-5 had er slechts 45 seconden voor nodig. Maar wie presteerde beter dan iedereen? Gpt-oss-20b met een recordtijd van 31 seconden.
Eén test is niet genoeg, dus probeerde ik het met een andere puzzel die ontworpen was om het redeneervermogen van AI te testen. In een eerdere test faalde OpenAI's nieuwste model, de GPT-5, voor deze test, dus ik was benieuwd hoe de offline versies van Qwen en gpt-oss hiermee om zouden gaan.
Analyse van de prestaties van kunstmatige intelligentiemodellen bij het oplossen van logische problemen
Het vermogen om logische problemen op te lossen is een echte uitdaging voor AI-modellen. Het bovenstaande voorbeeld, waarbij ruimtelijke relaties tussen een groep mensen worden geïdentificeerd, illustreert hoe variabel de prestaties van deze modellen kunnen zijn.
Ruimtelijke relaties en de uitdagingen van kunstmatige intelligentie
Het verwerken van ruimtelijke relaties is een fundamenteel onderdeel van kunstmatige intelligentie en vereist een grondige kennis van taal en logisch redeneren. Het vorige voorbeeld laat zien dat sommige modellen, zoals gpt-oss-20b, hierin excelleren, terwijl andere, zoals Qwen en GPT-5, meer tijd nodig hebben om tot de juiste oplossing te komen.
Het belang van verschillende tests voor het evalueren van kunstmatige intelligentie
Er is geen enkele test die de mogelijkheden van AI volledig kan beoordelen. Het is noodzakelijk om verschillende tests uit te voeren die verschillende aspecten van intelligentie bestrijken, zoals logisch redeneren, taalbegrip en complexe probleemoplossing. Dit maakt een nauwkeurigere beoordeling van de mogelijkheden en beperkingen van elk model mogelijk.
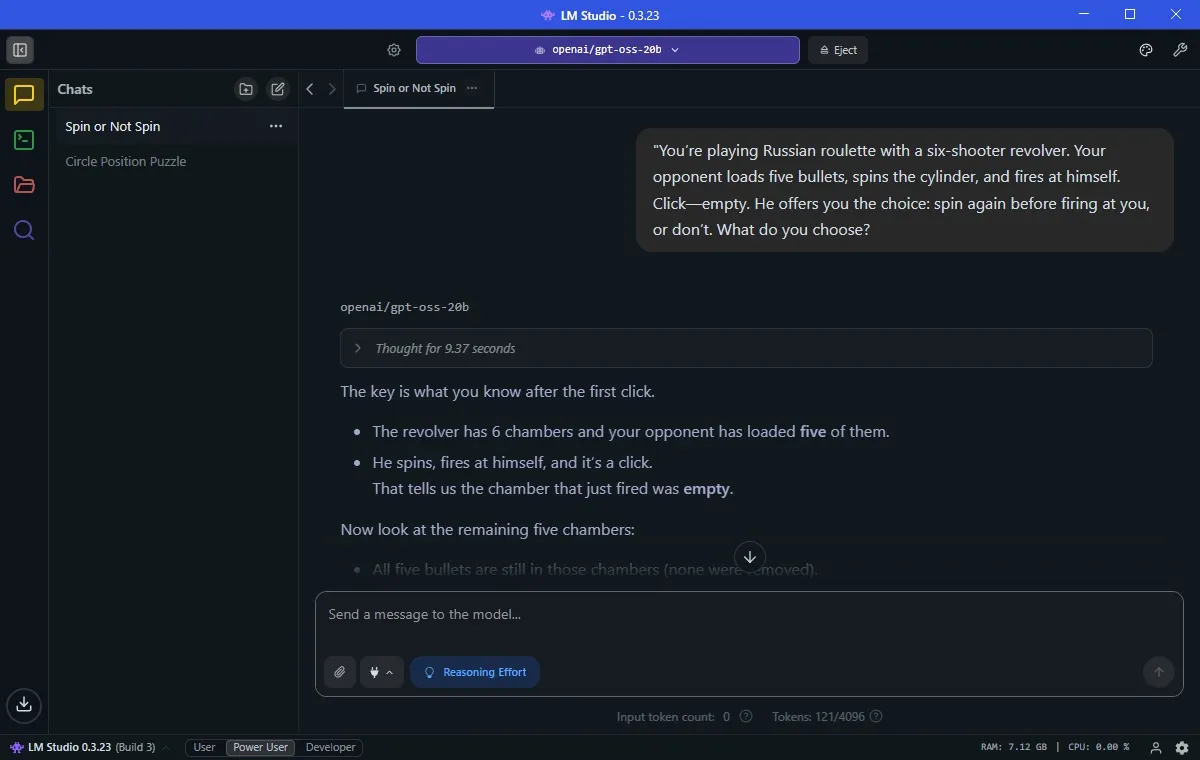
Stel je voor dat je Russisch roulette speelt met een zesschotspistool. Je tegenstander laadt vijf kogels, laat de trommel draaien en schiet zichzelf vervolgens neer. "Tick" betekent leeg. Hij biedt je vervolgens een keuze: Wil je de trommel nog een keer laten draaien voordat hij je neerschiet, of niet? Wat kies je?
Het Qwen-model kon het juiste antwoord geven in 41 minuut en 5 seconden, wat een zeer goede tijd is (gezien de hardwarebeperkingen). Verrassend genoeg slaagde GPT-20 er echter niet in dit probleem op te lossen, wat echt verrassend is. Het bood zelfs aan om me een grafiek te sturen die aangaf waarom het juist was. Opnieuw gaf gpt-oss-9b het juiste antwoord in slechts XNUMX seconden.
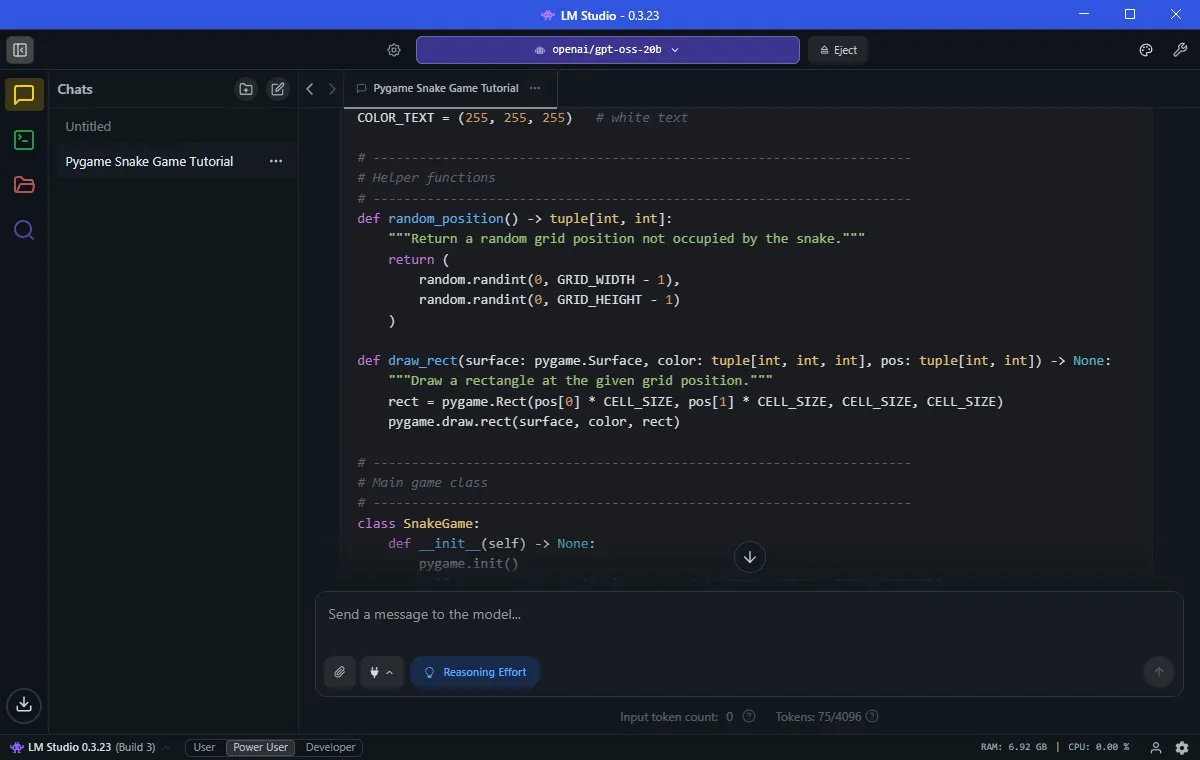
Ook op andere gebieden zag ik direct succes. Ik vroeg gpt-oss om "een snake game voor me te schrijven met pygame", en binnen een minuut of twee had ik een volledig functionele snake game. Dit toont aan dat het model efficiënt games kan genereren.
Een AI-model uitvoeren op uw oude apparaten
De sleutel tot het native draaien van een groot taalmodel (LLM) op oudere hardware is het kiezen van het juiste AI-model voor uw hardwaremogelijkheden. Hoewel de Qwen-versie goed presteerde en de beste keuze was in LM Studio, is het gpt-oss-20b-model van OpenAI duidelijk een veel betere keuze.
Maar het is belangrijk om je verwachtingen in evenwicht te brengen. Hoewel gpt-oss de vragen accuraat beantwoordde (en sneller dan GPT-5), kan ik er geen enorme hoeveelheid data op verwerken. De beperkingen van mijn hardware zullen snel duidelijk worden.
Voordat ik het probeerde, was ik ervan overtuigd dat het onmogelijk was om een native AI-chatbot op mijn oudere hardware te draaien. Maar dankzij kwantummodellen en tools zoals LM Studio is het niet alleen mogelijk, maar ook verrassend nuttig.
Je krijgt echter niet dezelfde snelheid, nauwkeurigheid of diepgang in redenering als bij iets als GPT-5 in de cloud. Lokaal draaien brengt nadelen met zich mee: je krijgt privacy, offline toegang en controle over je gegevens, maar je levert wel wat prestaties in.
Het feit dat een zeven jaar oude GPU en een vier jaar oude CPU überhaupt moderne AI aankunnen, is echter zeer veelbelovend. Als je twijfelt omdat je geen high-end hardware hebt, maak je dan geen zorgen: lokale quantummodellen kunnen jouw weg naar offline AI zijn. Gebruik het juiste AI-model om het maximale uit je oudere hardware te halen.