Ik ben de laatste tijd erg enthousiast geworden over het lokaal uitvoeren van grote taalmodellen (LLM's), en nadat ik al die Coole dingen die je kunt doen met MCP-toolsIk besefte dat het tijd was om mijn eigen instellingen wat aan te passen.

Aanvankelijk sprong ik op de hype-trein toen de DeepSeek R1 werd uitgebracht, maar sindsdien zijn er veel nieuwe modellen verschenen. Omdat alles zo snel verandert, leek het me verstandig om mijn workflow ook te optimaliseren.
Snelle links
LM Studio is de beste lokale LLM-app die ik tot nu toe heb gebruikt.
Ollama is lekker, maar ik geef de voorkeur aan dit.
Ik ben vorig jaar voor het eerst gaan experimenteren met Local Large Language Models (LLM's) met behulp van Ollama.Het werkte redelijk goed, maar mijn arme MacBook Air met slechts 8 GB RAM was absoluut niet ontworpen om dat soort werk aan te kunnen. Ik wilde toch iets anders proberen, deels uit nieuwsgierigheid en deels om te zien of ik er nog meer prestaties uit kon halen.
Daarom besloot ik LM Studio te proberen. Het is een applicatie waarmee je Large Language Models (LLM's) lokaal op je computer kunt downloaden en uitvoeren, en het heeft bovendien een overzichtelijke gebruikersinterface. Omdat ik een Mac gebruik, was MLX-ondersteuning cruciaal voor mij. Mocht je er niet bekend mee zijn: MLX is Apple's machine learning-framework dat speciaal is ontworpen voor Apple Silicon.
Het zorgt er in feite voor dat modellen efficiënter kunnen draaien met behulp van de grafische processor (GPU). Ik wilde deze woorden echter in cijfers uitdrukken, dus heb ik Ollama en LMStudio rechtstreeks met elkaar vergeleken, met behulp van hetzelfde model.
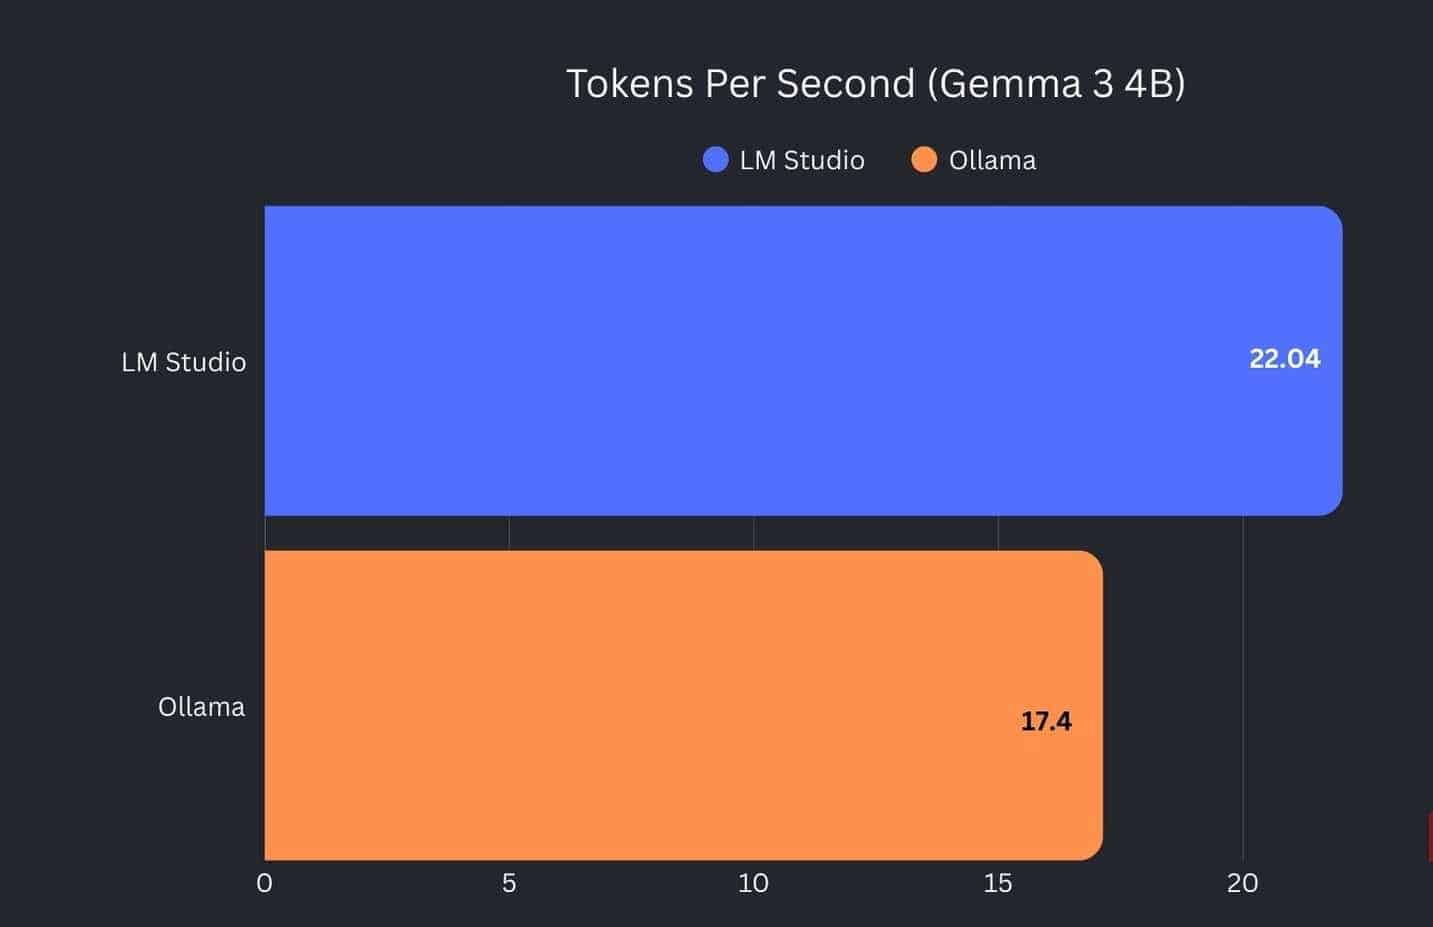
Met LM Studio kreeg ik weliswaar een hoger aantal symbolen per seconde, maar het verschil was zo klein dat het de algehele ervaring niet echt veranderde. Toch zou ik elke extra prestatieverbetering waarderen.
Ik denk echter niet dat het veel uitmaakt of je nu voor Ollama of LM Studio kiest, vooral omdat ze allebei gebruikmaken van vergelijkbare basisstructuren voor het lokaal uitvoeren van modellen.
Mijn grootste bezwaar toen ik begon, was het gebrek aan multimediaondersteuning. Maar dat is nu geen probleem meer. Zowel Ollama als LM Studio ondersteunen nu multimediasjablonen, en er zijn een aantal krachtige opties die tekst en afbeeldingen goed kunnen verwerken op lokale apparaten.
Het kiezen van het juiste model kan best lastig zijn.
Het kan een dure hobby zijn.
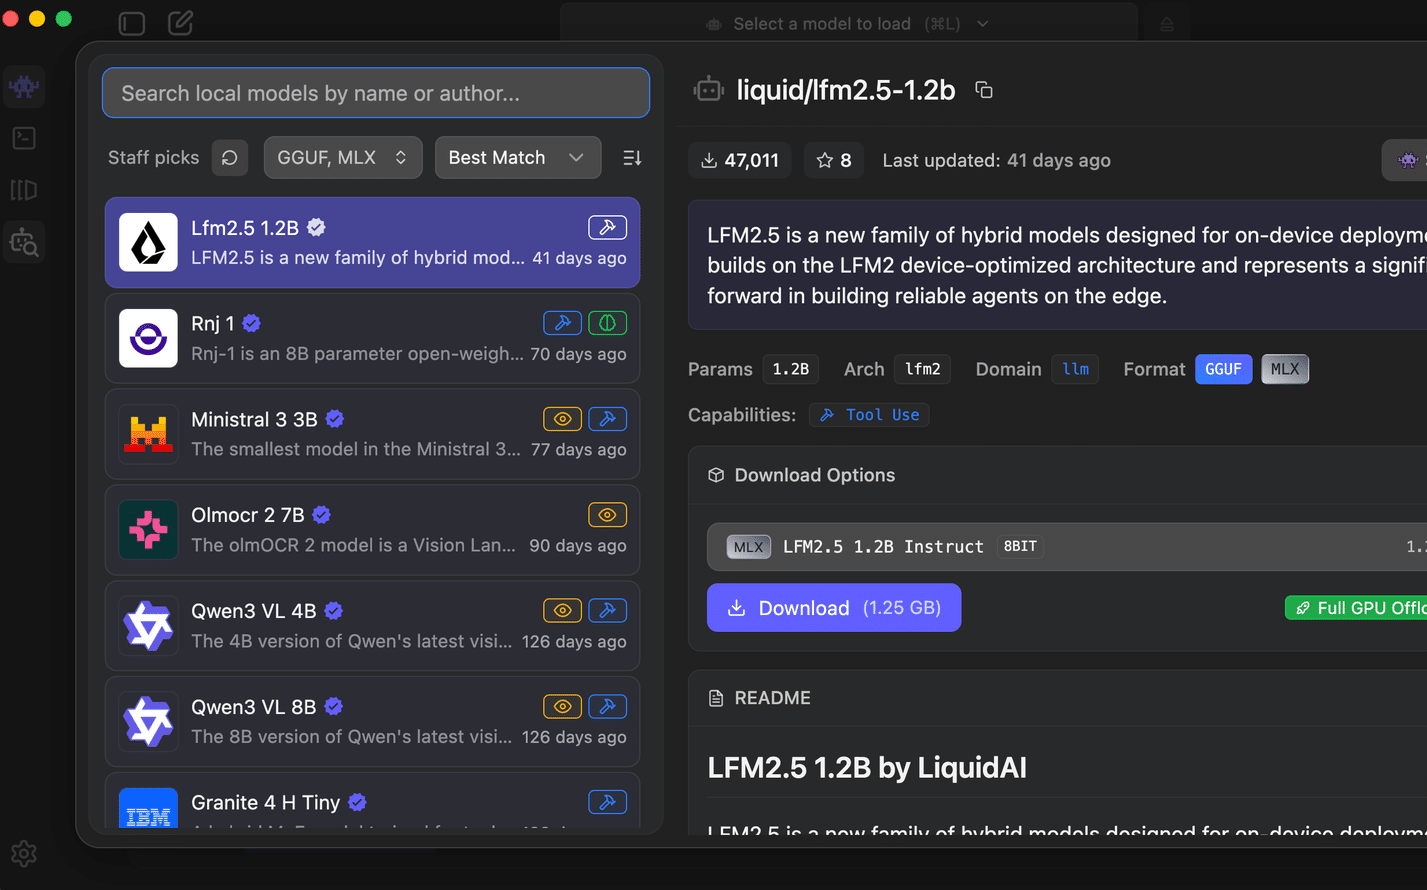
Wanneer je LM Studio voor het eerst installeert, moet je eerst een sjabloon kiezen. Dit kan een beetje verwarrend lijken als je hier nieuw mee bent, omdat er geen eenduidig antwoord is zoals "gebruik dit sjabloon". De juiste keuze hangt echt af van je hardware.
Als je het menu 'Model zoeken' in LM Studio opent, zie je een lijst met de populairste modellen. Een eenvoudige manier om te begrijpen hoe gewild een model is, is door te kijken naar het getal direct vóór de letter 'B' in de naam.
De "B" staat voor miljarden parameters. Over het algemeen geldt: hoe hoger dit getal, hoe krachtiger het model. Dit betekent echter ook dat het meer systeembronnen vereist. Op een Mac met 8 GB VRAM vind ik 3 tot 4 miljard parameters een goede hoeveelheid. Op een pc kan het wat complexer worden. Daar is niet het gewone RAM-geheugen, maar de hoeveelheid VRAM die je hebt het belangrijkst.
Als je 8 GB VRAM hebt, kun je gerust experimenteren met modellen die 7B-parameters gebruiken, vooral in lichtere quantumconfiguraties. Mijn ervaring is dat de beste aanpak is om te beginnen met een kleiner model en geleidelijk aan naar een groter model toe te werken totdat je de juiste configuratie hebt gevonden.
Persoonlijk voelde ik me meer aangetrokken tot het Gemma 3 4B-model, dat op dezelfde basis is gebouwd als de Gemini-modellen van Google. Ik zou echter zeker aanraden om ook de Qwen-modellen te proberen. Afhankelijk van wat je ermee wilt doen, is dat misschien wel een veel betere keuze.
Je kunt zelfs een webzoekfunctie toevoegen aan je lokale LLM-cursus.
DuckDuckGo schiet te hulp.
Een van de grootste klachten die ik heb gezien over native Large Language Models (LLM's) is hoe beperkt ze zijn in vergelijking met cloudgebaseerde modellen zoals ChatGPT als het gaat om webzoekopdrachten. Het is niet erg nuttig om te vragen naar de nieuwste iPhone en dat de LLM vervolgens begint over de iPhone 14. Dit is een gebied waar cloudgebaseerde modellen superieur zijn gebleken.
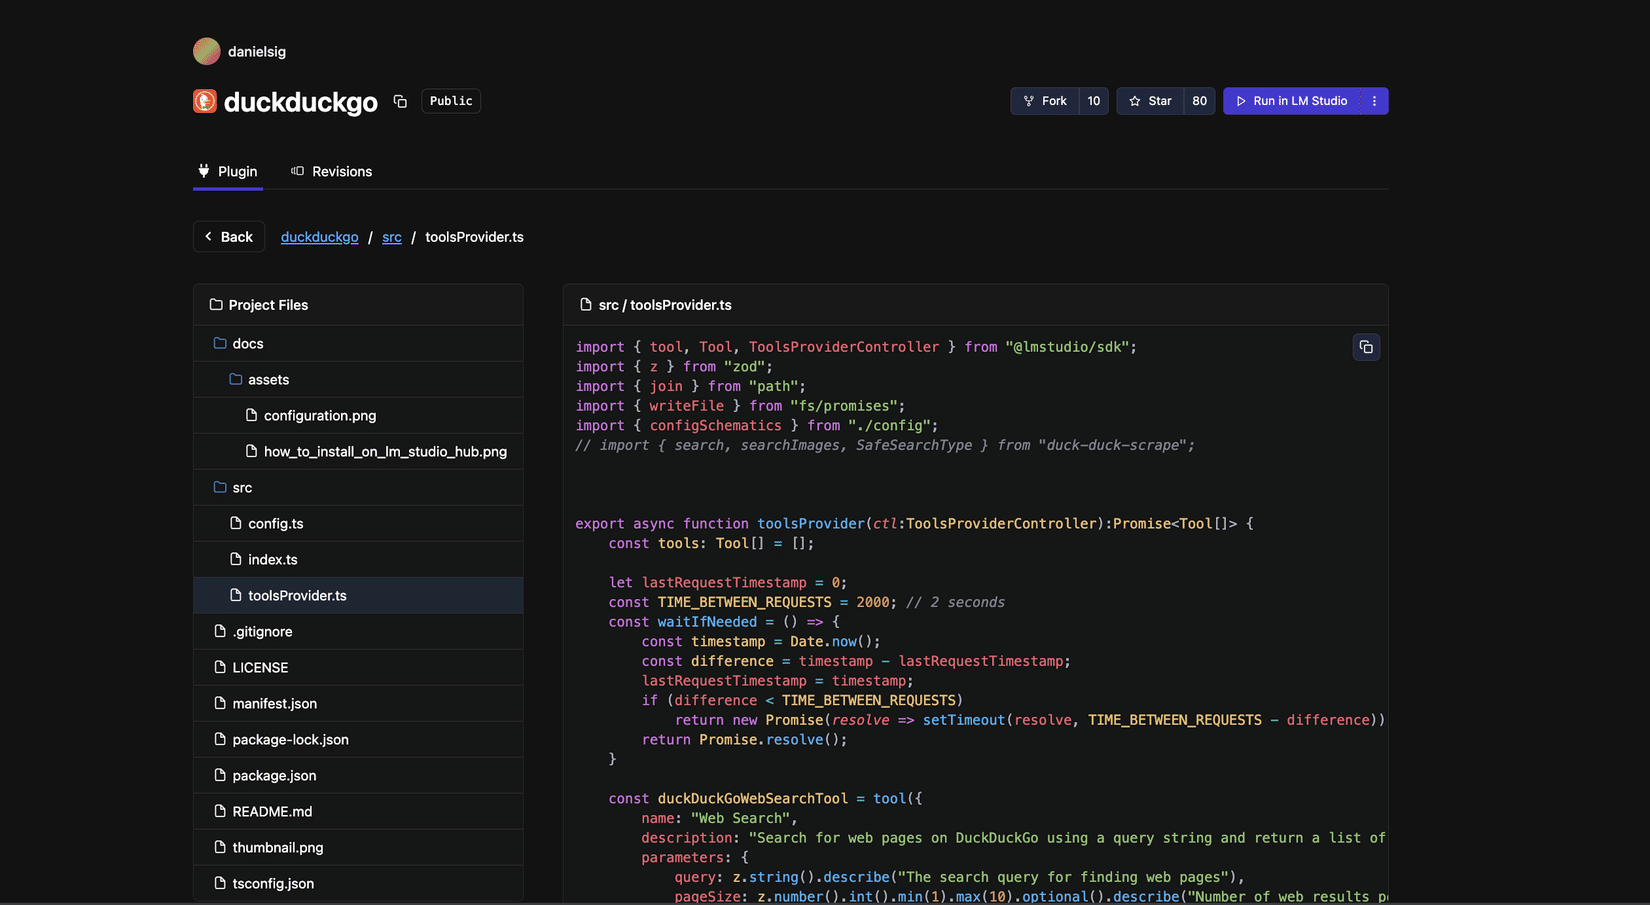
LM Studio heeft een ingebouwd plug-insysteem en het toevoegen van webzoekfunctionaliteit is ongelooflijk eenvoudig. Ga gewoon naar DuckDuckGo-add-onpaginaEn geef in LM Studio aan dat je het wilt uitvoeren.
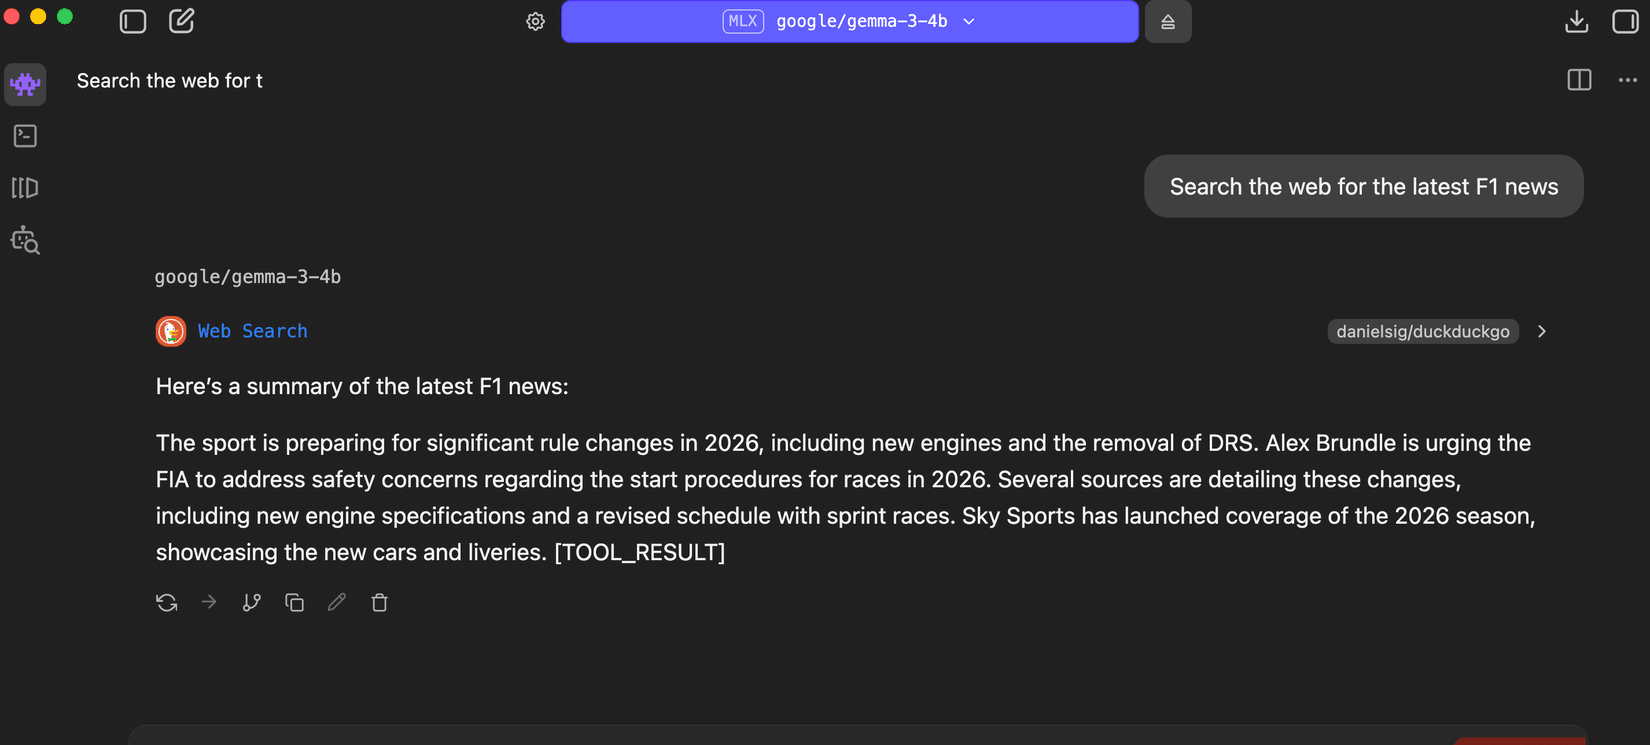
Zodra deze optie is ingeschakeld, verschijnt er bij het uitvoeren van een formulier een optie onder het chatvenster waarin wordt gevraagd of u DuckDuckGo wilt gebruiken voor uw zoekopdracht. Als u deze optie inschakelt, haalt LM Studio live zoekresultaten op en vult deze in het formulier in voordat er een antwoord wordt gegenereerd.
Dat is niet alles wat je met plugins kunt doen. Het LM Studio-team heeft ook een aantal zeer nuttige plugins ontwikkeld. Zo hebben ze bijvoorbeeld een Wikipedia-plugin waarmee je grote taalmodel artikelen van Wikipedia kan lezen en doorzoeken (uiteraard).
Er is ook nog de JavaScript Sandbox-plugin, die erg handig kan zijn als je geïnteresseerd bent in 'vibe-coding' en snel een idee wilt krijgen van wat er gebouwd wordt. Maar ik zou niet zeggen dat het de moeite waard is om er iets productieklaars mee te maken.
Weg met de grote bedrijven!
Je kunt LM Studio zo instellen dat je vanaf je telefoon toegang hebt tot je grote taalmodel, maar als je alle inferentie direct naar je telefoon wilt overzetten, is dat ook mogelijk. Het uitvoeren van kleinere en grotere taalmodellen op een Android-telefoon.Hoewel het niet zo krachtig zal zijn als wat je op een Mac krijgt.
De verbetering van deze lichtgewicht modellen gaat in een snel en indrukwekkend tempo door. Nu de hardwarekosten naar verwachting zullen stijgen, zou het me niet verbazen als bedrijven zoals OpenAI of Google hun abonnementsprijzen verhogen. Het is geruststellend om een opstelling te hebben die daar geen last van heeft.