Een vast onderdeel van mijn dagelijkse werkroutine is het schakelen tussen macOS, Windows en Linux. Een van de grootste uitdagingen bij het werken met deze systemen is de impact ervan op mijn opslagorganisatie. Bestanden vermenigvuldigen zich razendsnel en op elk systeem krijg ik uiteindelijk meerdere duplicaten. Ik heb screenshots in verschillende standaardmappen; ik heb dezelfde documenten meerdere keren op dezelfde apparaten gedownload; en ik heb bijna identieke kopieën van bestanden via cloudsynchronisatie.

Ik gebruik meestal opschoonprogramma's die beter compatibel lijken met mijn besturingssysteem, en zelfs als ze effectief zijn, is het lastig om consistent te blijven op verschillende apparaten. Daarom ben ik overgestapt op dupeGuru, een tool die dubbele bestanden vindt en verwijdert. Het werkt vergelijkbaar met AllDup.Maar het is ideaal omdat het het gedrag op alle platformen niet verandert.
Snelle links
Hoe bepaalt dupeGuru dat twee bestanden "identiek" zijn?
De overeenkomende logica die de duplicaten detecteerde, was gestopt met zoeken.

Veel ingebouwde tools voor het opruimen van bestanden missen een hoop bestanden omdat ze naar duplicaten zoeken op basis van bestandsnamen. dupeGuru Een op inhoud gebaseerd matchingsysteem. Op deze manier wordt de bestandsnaam overgeslagen en wordt de inhoud van het bestand onderzocht. Toen ik zag dat dupeGuru bestanden sorteerde op inhoud, realiseerde ik me dat ik het aantal duplicaten dat ik had, had onderschat.
Als ik dupeGuru gebruik, schakel ik zelden tussen modi, en als ik dat wel doe, is dat bewust. De standaardversie van dupeGuru is voldoende voor de meeste documenten, archieven en willekeurige bestanden die ik heb. Ik gebruik echter de muziekversie als er dubbele audiobestanden verborgen zitten achter verschillen in metadata, en als ik afbeeldingen verklein of comprimeer, is de fotoversie mijn voorkeursoptie. De algemene regel is dus om de standaardmodus te gebruiken voor algemene schijfopruiming en over te schakelen naar een andere modus wanneer je te maken hebt met specifieke mediabestanden.
DupeGuru hanteert een drempelwaarde voor gelijkenis die enige ambiguiteit toelaat. 100% gelijkenis betekent dat de bestanden gegevens bevatten die perfecte kopieën van elkaar zijn; hoe lager het percentage, hoe minder de bestanden overeenkomen. Hoewel ik hoge percentages voor afbeeldingen vertrouw, ben ik strenger voor documenten.
Alles controleren is de snelste manier om nutteloze resultaten te krijgen.
De mapstrategie die de inspectieprocessen uiteindelijk voorspelbaar maakte.
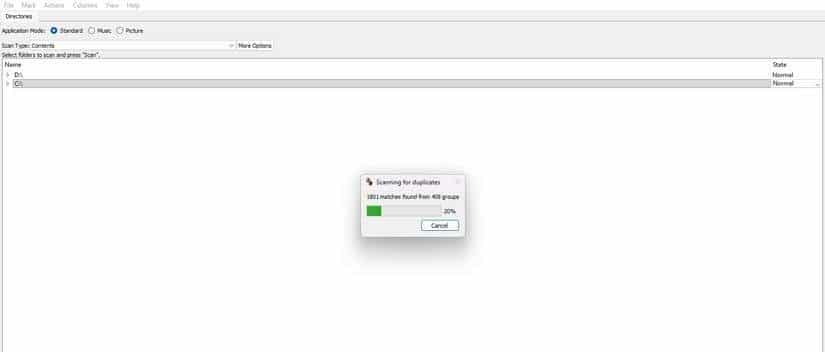
De eerste resultaten die ik met dupeGuru kreeg, waren erg verwarrend. Maar ik realiseerde me dat de reden mijn manier van werken was. Ik verwees simpelweg naar een complete map en liet het programma draaien. Dit leverde doorgaans veel meer resultaten op dan ik de energie of het vertrouwen had om te bekijken. Dit was een geval van slechte invoer die leidde tot slechte beslissingen, zelfs al was de tool zelf goed.
Mijn huidige aanpak is om de mappen die ik wil opschonen te scheiden van de mappen die ik vertrouw. Ik wijs bepaalde mappen aan als referentiemappen als ik daar originelen, archieven of samengestelde collecties in wil bewaren. Op deze manier stelt dupeGuru niet voor om de kopieën in de referentiemap te verwijderen wanneer er dubbele exemplaren worden gevonden.
Ik sluit bepaalde mappen uit van de scans. Dit zijn mappen met systeemmappen, applicatiepakketten en pakketbeheerders. Door deze locaties te vermijden, filter ik veel overbodige bestanden eruit. Bovendien zorgt een smaller scanbereik voor snellere en duidelijkere resultaten. Het scheelt ook een hoop denkwerk bij het bepalen wat er verwijderd moet worden.



Leer de resultaten van dupeGuru te lezen in plaats van ermee te interageren.
De kolommen waar ik aandacht aan besteed en de kolommen die ik meestal negeer.
Aanvankelijk concentreerde ik me vooral op het percentage overeenkomsten. Na verloop van tijd realiseerde ik me dat dit een vergissing was, omdat het percentage alleen de gelijkenis aangeeft, niet het belang. De belangrijkere elementen waren de grootte, de locatie en of een bepaald bestand zich in een referentiemap bevond. Door de tabel rustig te lezen in plaats van direct te reageren, werden de verwijderingen nauwkeuriger.
Door de resultaten op grootte te sorteren, kan ik eerst de duplicaten aanpakken die de meeste ruimte innemen. Ik gebruik ook deltawaarden in mediagerichte scans om te begrijpen wat de bestanden precies zijn, en mappaden geven me een idee waarom sommige duplicaten bestaan. Dit alles biedt context die het nemen van beslissingen gemakkelijker maakt.
De echte doorbraak is echter de bestandsvoorbeeldfunctie. Ik hoef niet meer te gissen naar overeenkomsten als ik ze gewoon kan openen. Ik denk niet dat de preview van dupeGuru perfect werkt op elk besturingssysteem, maar het is wel een snelle manier om vertrouwen op te bouwen. Door te vertrouwen op wat ik zie, wordt opschonen minder riskant. Ik had een manier nodig om primaire opslagruimte vrij te maken.Deze duidelijkheid helpt je te weten wat je weg moet doen.
Gebruik dupeGuru op dezelfde manier op elk besturingssysteem.
Waarom veranderde deze consistentie de frequentie waarmee ik mijn schijven schoonmaakte?
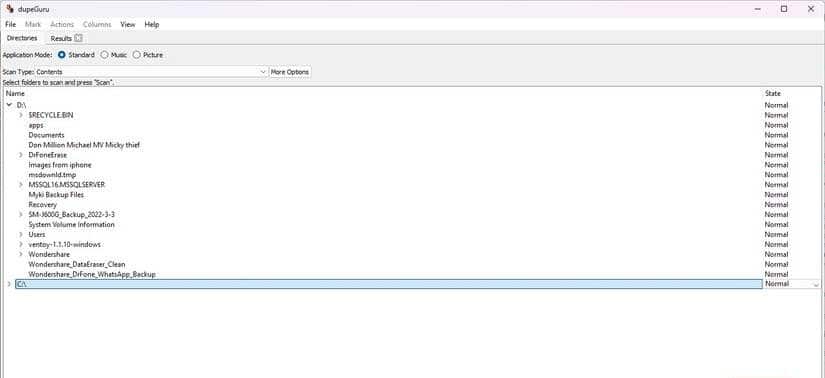
Wat dupeGuru echter zo bijzonder maakt, gaat veel verder dan alleen de functies. De tool werkt op alle platforms die ik gebruik hetzelfde: Linux, Windows en macOS. Het ontwerp, de scanprocedure en de resultaattabellen zijn consistent, waardoor ik niet blijf uitstellen om op te schonen, ook al werk ik op een andere computer.
dupeGuru werkt op externe schijven op dezelfde manier, ongeacht het platform. Ik kan ze scannen met dezelfde toewijzingslogica en de resultaten bekijken met dezelfde controlemethoden. dupeGuru heeft ook een commandoregelinterface, wat handig is wanneer ik repetitieve taken moet uitvoeren of deel moet nemen aan externe sessies, hoewel de grafische gebruikersinterface mijn voorkeur heeft voor de dagelijkse opruiming.
Ik begon de multi-platformfunctionaliteit van dupeGuru pas echt te waarderen toen ik na jarenlang handmatig synchroniseren en kopiëren een fotobibliotheek had die over alle drie de platforms verspreid was. Het was geen magische oplossing, maar dupeGuru gaf me wel alle duidelijkheid die ik nodig had om te zien wat er gedupliceerd was en waar.
Wat leer je van langdurig gebruik?
Als je grote scans moet uitvoeren, is dupeGuru niet de snelste tool voor het opschonen van bestanden, en het kan omslachtig aanvoelen als je het gebruikt op zeer grote schijven. Daarom is het opsplitsen van de taken in kleinere delen een belangrijk alternatief. Hoewel dit in eerste instantie misschien trager lijkt, profiteer je enorm van het gemak waarmee je de resultaten kunt beheren.
Ik pas de muziek- en beeldinstellingen liever niet te veel aan, omdat dit soms tot onscherpe resultaten kan leiden. Het aanscherpen van de drempelwaarden voor gelijkenis of het terugzetten naar de standaardinstellingen lost dit op. Het grootste pluspunt is echter de consistentie op alle platformen. Zeer vergelijkbaar met tools voor het verwijderen van duplicaten zoals Czkawka..